Google-Agent : comprendre les agents IA qui visitent et utilisent votre site
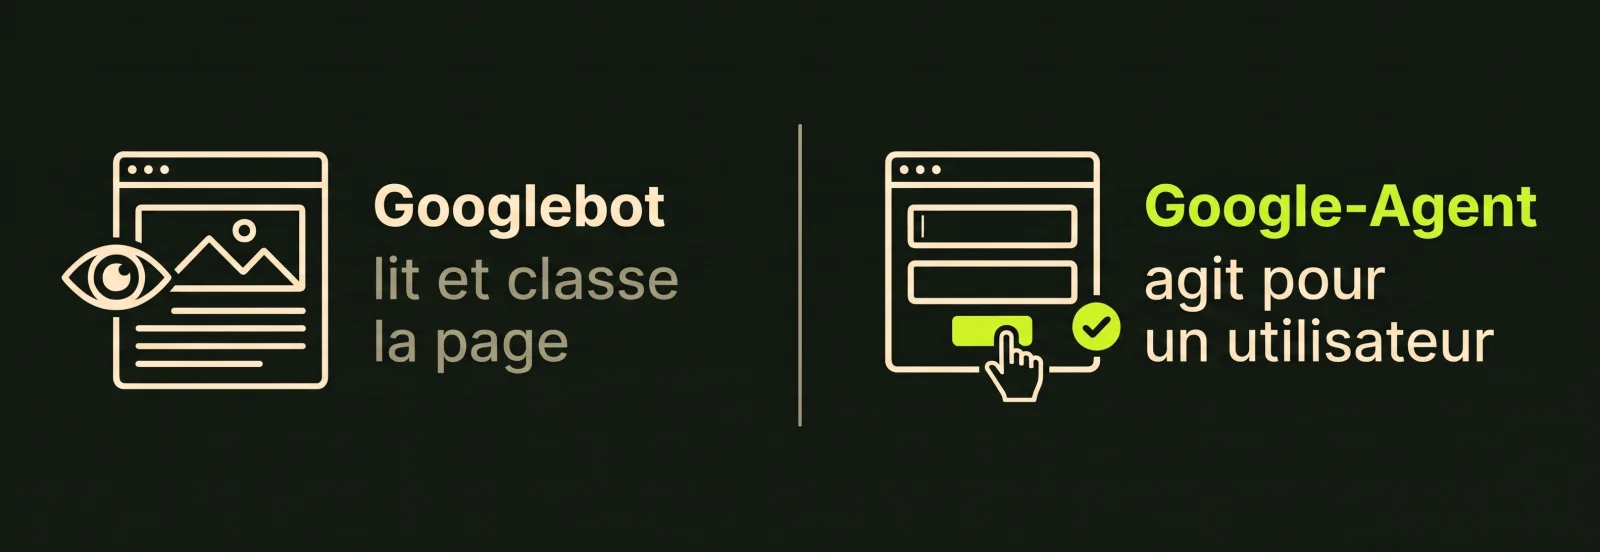
Jusqu'ici, deux types de visiteurs comptaient sur un site : les humains, et les robots d'indexation qui lisent les pages pour les classer. Google en documente désormais un troisième. Google-Agent est l'identifiant utilisé quand un agent IA hébergé par Google parcourt un site pour le compte d'une personne : il ouvre des pages, compare, et peut effectuer des actions qu'on lui a demandées.
Pour une équipe marketing, la question n'est pas technique. Derrière cette visite automatisée, il y a quelqu'un qui cherche une offre. Si le site bloque l'agent IA à la deuxième page, ou s'il ne lui montre rien d'exploitable, c'est une demande qui s'arrête sans que personne ne s'en aperçoive.
Cet article explique ce que Google documente réellement sur Google-Agent, ce qu'il ne dit pas, ce que fait Modern Web Guidance (le kit que Chrome publie pour les assistants de code IA), et comment j'intègre ces sujets dans l'examen d'un site.
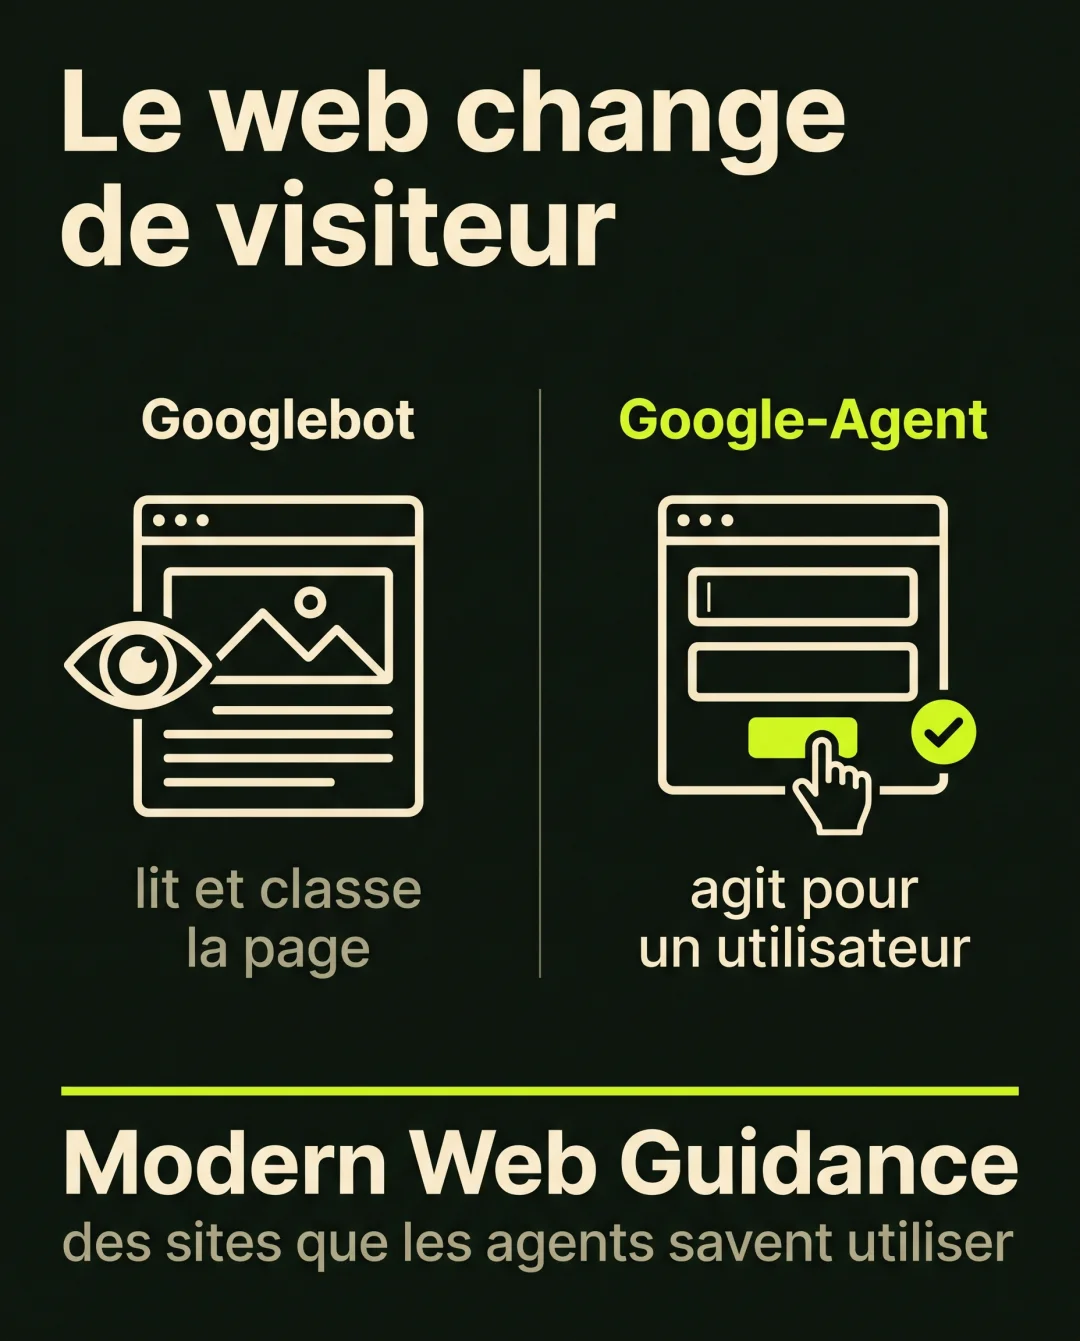
Google-Agent en bref
- Ce que c'est : un user agent, c'est-à-dire la signature qu'un visiteur automatisé envoie au serveur pour se présenter. Celle-ci contient « compatible; Google-Agent ».
- Qui l'utilise : selon Google, des agents IA hébergés sur son infrastructure, pour « naviguer sur le web et effectuer des actions à la demande de l'utilisateur ».
- Ce que Google ne dit pas : quels produits l'utilisent, ni avec quel volume. Les noms qui circulent sur les réseaux relèvent de la déduction, pas de la documentation.
- Depuis quand : l'entrée a été ajoutée à la documentation des robots de Google le 20 mars 2026, selon plusieurs médias spécialisés (dont MarkTechPost, le 28 mars 2026). La page elle-même n'affiche pas de date.
Ce que Google documente réellement
Google classe ses visiteurs automatisés en plusieurs familles. Les plus connus sont les robots d'exploration, comme Googlebot, qui parcourent le web de leur propre initiative pour alimenter l'index. Google-Agent appartient à une autre famille : les user-triggered fetchers, des outils de récupération déclenchés par un utilisateur. Rien ne se passe sans une demande humaine au départ.
Cette distinction a une conséquence directe sur le fichier robots.txt. Pour cette famille, Google écrit que, « comme la récupération a été demandée par un utilisateur, ces outils ignorent généralement les règles du robots.txt ». L'affirmation porte sur le groupe ; la page ne la répète pas nommément pour Google-Agent, mais il en fait partie.
Deux signatures sont publiées, l'une pour mobile, l'autre pour ordinateur. Toutes deux reprennent la signature d'un navigateur Chrome et ajoutent la mention Google-Agent avec un lien vers la documentation. Cela laisse penser que l'agent IA consulte les pages comme un navigateur, et pas comme un simple lecteur de texte ; Google ne détaille pas ce point.
Comment reconnaître une visite de Google-Agent
Google prévient lui-même que la signature d'un visiteur peut être usurpée. N'importe quel script peut se déclarer « Google-Agent ». La documentation propose donc plusieurs niveaux de vérification, à confier à l'équipe technique ou à l'hébergeur :
- La signature contient « Google-Agent ». C'est un premier filtre, jamais une preuve.
- L'adresse IP figure dans la liste publiée par Google pour cette famille d'outils, le fichier
user-triggered-agents.json. - La résolution DNS inverse de l'adresse renvoie vers un domaine Google. Pour les outils déclenchés par un utilisateur, Google indique des noms en
gae.googleusercontent.comou engoogle-proxy-….google.com, sans préciser lequel s'applique à Google-Agent. - La signature cryptographique Web Bot Auth, encore expérimentale. Google indique qu'« une partie des requêtes de Google-Agent » est signée, avec l'identité
https://agent.bot.goog, et que toutes ne le sont pas. Le protocole est un brouillon de l'IETF, susceptible d'évoluer : Google demande de conserver les méthodes de vérification classiques en parallèle.
Pour un décideur, retenir ceci suffit : une visite qui se dit Google-Agent se vérifie par l'adresse IP, pas par la déclaration.
Le vrai risque : bloquer un client sans le savoir
Le robots.txt n'est pas le bon levier pour ce visiteur : il l'ignore en général. Le risque se trouve ailleurs, dans les protections que beaucoup de sites ont empilées contre les robots : pare-feu applicatif, réseau de diffusion de contenu (CDN), outils de détection de robots, défis de type CAPTCHA.
Google a publié un guide dédié, « Allow Google-Agent traffic ». Il recommande d'autoriser explicitement les requêtes vérifiées de Google-Agent dans ces outils, tout en gardant les autres contrôles de sécurité. Les points d'attention qu'il liste parlent directement à une équipe acquisition :
- L'ordre des règles : l'autorisation doit passer avant les blocages larges, par exemple les règles « bloquer les agents IA » proposées par certains fournisseurs.
- Les défis : exempter les requêtes vérifiées des CAPTCHA et des défis JavaScript, pas seulement des blocages purs.
- Le parcours complet : la recherche interne, les filtres, les fiches détaillées, le tunnel de commande et les appels techniques qui les alimentent. Un accueil accessible ne suffit pas si la page suivante est verrouillée.
- Les limites de fréquence : de nombreux utilisateurs partagent les mêmes adresses IP de sortie. Une limite par adresse calibrée pour un humain peut bloquer plusieurs personnes à la fois.
- La mise à jour des listes d'adresses IP, et la conservation des en-têtes utiles par les équilibreurs de charge et les proxys.
Deux confusions reviennent souvent dans les réponses générées par IA sur ce sujet. La première consiste à conseiller de « ne pas bloquer Google-Agent dans le robots.txt » : la consigne est sans objet, puisqu'il l'ignore en général. La seconde mélange Google-Agent et Google-Extended. Google-Extended est un jeton du robots.txt qui permet de gérer l'usage des contenus pour l'entraînement des futurs modèles Gemini et l'ancrage de certains produits d'IA de Google. Il n'a pas de signature propre, n'influe ni sur la présence dans la recherche Google ni sur le classement, et n'a rien à voir avec un agent IA qui navigue pour un utilisateur.
Modern Web Guidance : Google outille aussi la fabrication des sites
En parallèle, l'équipe Chrome publie Modern Web Guidance. Google le décrit comme « un ensemble de compétences qui intègrent l'expertise de la plateforme web, les bonnes pratiques et les données de compatibilité des navigateurs directement dans vos assistants de code IA ».
Concrètement, c'est une bibliothèque de plus de 200 guides que des outils comme Claude Code, Codex, Cursor, Antigravity, Copilot ou WebStorm consultent pendant qu'ils écrivent du code. Les thèmes couverts : CSS, interfaces, HTML, JavaScript, Core Web Vitals, accessibilité, sécurité et IA dans le navigateur.
Les jalons publiés :
- Préversion annoncée à Google I/O, le 19 mai 2026.
- Version 1.0 publiée le 10 novembre 2026. Firefox et Edge rejoignent Chrome pour soutenir le projet.
- Un module de modernisation qui analyse le code existant pour repérer des mises à niveau sûres. Google précise que cette première version repose sur une analyse statique d'un ensemble limité de motifs : elle ne remplace pas une revue complète.
Le chiffre mis en avant par Google vient de son tableau d'évaluation public : environ 51 % de réussite pour les modèles non guidés, contre 91 % avec Modern Web Guidance. C'est une mesure de Google, sur ses propres critères de qualité de code, pas un indicateur de visibilité ou de conversion.
Pour une équipe marketing, l'intérêt est indirect mais réel. Une part croissante des sites et des pages est désormais produite ou modifiée avec un assistant de code IA. Un assistant mieux guidé produit plus souvent des formulaires correctement étiquetés, des pages qui ne bougent pas pendant le chargement et des images priorisées. Ce sont aussi les qualités dont un agent IA a besoin pour utiliser un site.
Ce que je lis dans ce mouvement
Google n'écrit nulle part que Modern Web Guidance a été créé pour Google-Agent. Le rapprochement qui suit est mon analyse.
D'un côté, Google documente un visiteur qui navigue et agit pour un utilisateur. De l'autre, Chrome outille les assistants de code IA pour produire des sites plus accessibles, plus stables et plus sûrs. Et la page de Modern Web Guidance met elle-même en avant un article intitulé « A developer toolkit to make your website agent-ready » : un kit pour rendre un site utilisable par des agents IA.
Cet article présente notamment une nouvelle catégorie Lighthouse, Agentic browsing. Ce qu'elle examine, selon la documentation Chrome :
- L'accessibilité vue par un agent IA : un sous-ensemble des contrôles d'accessibilité, centré sur les noms et libellés des éléments, l'intégrité de l'arbre d'accessibilité et la visibilité. Google écrit qu'« un arbre d'accessibilité bien formé est le principal moyen pour les agents IA de comprendre une page ».
- La stabilité : le CLS, cet indicateur qui mesure les éléments qui se déplacent pendant le chargement.
- WebMCP : une proposition de standard pour exposer aux agents IA des outils structurés, par exemple un formulaire décrit de façon explicite. Ces contrôles exigent de s'inscrire à une phase de test de Chrome.
- La présence d'un fichier
llms.txtà la racine du domaine. À noter : la documentation Google Search indique de son côté qu'aucun fichier texte destiné à l'IA n'est nécessaire pour apparaître dans ses fonctionnalités d'IA. Les deux affirmations portent sur des usages différents ; aucune ne fait de ce fichier une condition de visibilité.
Les limites sont écrites noir sur blanc : la catégorie est expérimentale, exige Chrome 150 ou plus récent, et son résultat est « informatif et non étalonné ». Pas de note sur 100, mais une proportion de contrôles réussis. Un bon résultat ne garantit ni visite, ni citation, ni demande.
La lecture que j'en retiens est plus sobre qu'une course à la « compatibilité agents IA » : ce que Google mesure ici, ce sont surtout les fondamentaux de l'accessibilité et de la qualité technique. Un site qui les respecte sert déjà mieux les humains, les lecteurs d'écran et les agents IA.
Ce que cela change pour la visibilité, les conversions et les audits
Visibilité. Rien de nouveau à baliser. Pour AI Overviews et AI Mode, Google indique qu'il n'existe ni exigence supplémentaire, ni fichier spécial, ni balisage Schema.org spécifique. Les fondamentaux restent : pages explorables, contenus importants disponibles en texte, données structurées cohérentes avec le texte visible. Google-Agent ne change pas ces règles ; il concerne ce qui se passe après, quand quelqu'un délègue la suite du parcours. Pour le travail de fond sur la visibilité, voir ce qui se travaille pour être repris dans les réponses des IA.
Conversions. Le parcours d'un client peut désormais passer par une étape déléguée : « compare ces trois prestataires », « vérifie les disponibilités », « prépare une demande ». Si l'information décisive (prix ou fourchette, délais, zone couverte, conditions) n'existe que dans une image, un PDF ou après un échange, l'agent IA ne peut pas la rapporter. Si le formulaire n'a pas de libellés lisibles, il ne peut pas le préparer correctement. Ce qui gêne l'agent IA gêne souvent aussi un humain pressé ou une personne qui navigue au clavier.
Audits. Un audit SEO examine depuis longtemps ce que les robots d'indexation peuvent lire. Il devient utile de vérifier aussi qu'un visiteur automatisé légitime peut aller au bout d'un parcours, sans affaiblir la sécurité. Le volume réel de ces visites reste à mesurer site par site : les journaux du serveur sont la référence pour les repérer, car les outils d'analyse d'audience peuvent les filtrer ou les compter différemment.
Checklist d'audit : votre site est-il utilisable par un agent IA ?
À passer avec l'équipe technique ou le prestataire du site. Aucun point ne garantit une visite ni une citation ; chacun retire un obstacle documenté.
Le parcours de conversion
- Le parcours principal (de la page d'offre jusqu'à l'envoi de la demande ou à la commande) se fait entièrement au clavier, avec un focus visible.
- Les boutons sont de vrais boutons et les liens de vrais liens, avec un intitulé explicite (« Demander un devis », pas « Cliquez ici » ni une icône seule).
- Chaque champ de formulaire a un libellé associé ; les messages d'erreur disent quoi corriger.
- Aucune étape du parcours ne dépend d'un CAPTCHA impossible à franchir pour une requête vérifiée.
L'information décisive
- Prix ou fourchette, délais, zones, conditions et preuves sont écrits dans la page, en texte, et pas seulement dans une image, un PDF ou une vidéo.
- Les réponses aux questions fréquentes sont présentes dans le HTML, même si elles s'affichent dans un élément dépliable.
- Les données structurées ne décrivent que ce qui est visible sur la page.
Le filtrage des robots
- L'équipe technique sait si le CDN, le pare-feu ou l'outil anti-robots bloque ou défie Google-Agent, et à quelle étape.
- Les requêtes sont vérifiées par adresse IP (et par signature Web Bot Auth quand elle est présente), pas par la seule déclaration du visiteur.
- La règle d'autorisation passe avant les blocages larges du type « bloquer les agents IA ».
- Les limites de fréquence tiennent compte des adresses IP partagées.
La mesure et les tests
- Une recherche de « Google-Agent » dans les journaux du serveur montre si ces visites existent, sur quelles pages, et avec quelles réponses (200, 403, 429…).
- Un test Lighthouse avec la catégorie Agentic browsing, dans un Chrome 150 ou plus récent, sert de repère de départ, à lire comme un signal expérimental et non comme une note.
- Le CLS des pages d'offre et de contact est surveillé : un bouton qui se déplace au chargement gêne un humain comme un agent IA.
Ce que j'en fais dans mes missions
Dans un audit SEO & IA, le cœur reste la sémantique, l'arborescence, les contenus, la technique et l'observation de la présence et des sources citées sur les requêtes analysées. Les points de cette checklist s'y ajoutent quand ils touchent la visibilité ou la conversion : informations clés écrites dans les pages, formulaires lisibles, parcours qui ne se bloque pas. Je ne vends pas d'audit de « compatibilité agents IA », et aucun réglage ne garantit qu'un agent IA choisira une entreprise plutôt qu'une autre.
L'accompagnement SEO & IA prend ensuite en charge la mise en œuvre avec l'équipe en place, y compris le dialogue avec les personnes qui gèrent l'hébergement et la sécurité.
Questions fréquentes
Faut-il autoriser Google-Agent dans le robots.txt ?
Ce n'est pas le levier pertinent. Google indique que les outils déclenchés par un utilisateur, dont Google-Agent fait partie, ignorent généralement les règles du robots.txt. Ce qui peut bloquer ces visites, ce sont plutôt le pare-feu, le CDN ou l'outil anti-robots du site.
Google-Agent est-il le robot qui indexe les pages pour Google ?
Non. L'indexation relève des robots d'exploration comme Googlebot. Google-Agent n'agit qu'à la demande d'un utilisateur, pour naviguer et effectuer des actions. Il appartient à une autre famille d'outils que le robot qui alimente l'index de recherche.
Quels produits Google utilisent Google-Agent ?
Google ne les nomme pas. La documentation parle seulement d'agents IA hébergés sur l'infrastructure de Google. Toute liste de produits relève de la déduction tant que Google ne l'a pas publiée.
Modern Web Guidance améliore-t-il le référencement ?
Pas directement. C'est un outil pour les assistants de code IA, destiné à produire du code plus moderne, accessible, performant et sûr. Il peut améliorer des fondamentaux qui comptent pour les utilisateurs, comme les Core Web Vitals ou l'accessibilité, mais Google ne le présente pas comme un levier de classement.
Un bon score Lighthouse Agentic browsing garantit-il d'être cité par une IA ?
Non. La catégorie est expérimentale et Google la qualifie d'informative et non étalonnée. Elle signale des obstacles techniques ; elle ne mesure ni la visibilité dans les réponses des IA ni la probabilité d'être recommandé.
Pour votre entreprise
Savoir où votre entreprise apparaît dans les réponses des IA.
Je mesure votre visibilité sur Google et dans les réponses des IA, puis je vous aide à mettre les priorités en œuvre.