Visibilité IA : le tableau de bord montre-t-il ce que voit un client ?
Un tableau de bord indique qu'une marque est absente de ChatGPT. Une personne de l'équipe pose la même question dans l'application et la voit apparaître. Avant de modifier le site ou de contester le reporting, une question permet de reprendre le problème : qu'a réellement observé l'outil ?
Certains outils interrogent les modèles par une API, une connexion entre logiciels. D'autres recueillent les réponses affichées dans l'application. Ces deux chemins peuvent produire des résultats différents. Pour une équipe marketing, l'enjeu est concret : savoir si le score présenté permet de décider où investir.
Cette analyse croise une recherche récente, deux études d'éditeurs et les documentations d'OpenAI et de Google. Les résultats chiffrés appartiennent aux auteurs cités ; je n'ai pas reproduit leurs expériences.
À retenir : avant d'utiliser un score de visibilité pour engager un budget, vérifier d'où viennent les réponses, ce que le score compte et si le constat revient dans le temps.
Que montre l'étude sur les écarts avec ChatGPT ?
Une étude de Marin et ses coauteurs, déposée en prépublication le 16 septembre 2026, compare les réponses à 117 questions sur des produits physiques. Les chercheurs interrogent ChatGPT, Gemini et les réponses des IA de Google, en répétant les questions et en comparant plusieurs modes d'accès.
Le recoupement moyen des sites cités entre l'application et l'API atteint 12 % pour ChatGPT et 14,8 % pour Gemini. Ces chiffres portent sur les sites communs aux deux réponses, rapportés à l'ensemble des sites cités. Ils ne mesurent pas la fiabilité des réponses.
La portée reste limitée : questions surtout anglophones, posées depuis les Pays-Bas sans compte connecté, trois répétitions. Les chercheurs ne peuvent pas vérifier que ChatGPT utilise le même modèle des deux côtés. L'étude ne permet donc ni d'isoler une cause unique ni de généraliser aux achats B2B en France.
Elle invite à vérifier le mode de collecte avant d'interpréter un score. Étude et méthodologie complètes.
Pourquoi la même question peut-elle produire deux relevés différents ?
ChatGPT peut adapter ses recherches à la localisation et aux informations mémorisées sur l'utilisateur. Un acheteur qui échange depuis plusieurs semaines avec l'application n'est donc pas dans la même situation qu'un outil qui pose une question sans ce contexte. Documentation de ChatGPT Search.
Autre différence possible : la recherche sur le web. Un outil peut autoriser cette recherche sans qu'elle soit déclenchée pour chaque question. Cela mérite une vérification auprès du prestataire. Documentation OpenAI.
Google précise aussi que ses résumés IA dans les résultats et son mode de recherche conversationnel peuvent fonctionner différemment. Les regrouper sous une seule colonne « Google IA » masque cette distinction. Documentation Google Search Central.
Ces mécanismes éclairent des écarts possibles. Ils n'identifient pas la cause exacte de chaque différence constatée entre deux réponses.
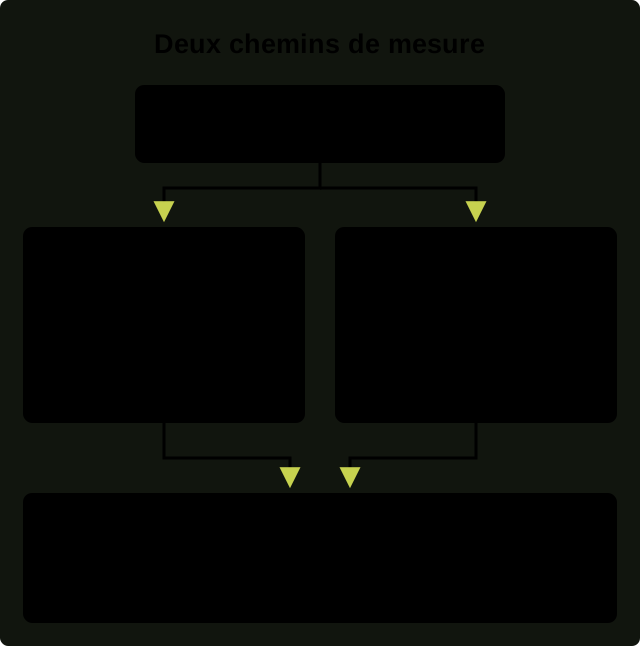
Schéma de principe : les deux chemins peuvent produire des réponses différentes, sans que l'un représente tous les acheteurs.
D'autres recherches retrouvent-elles ce problème ?
Oui, avec des méthodes différentes qu'il faut garder séparées.
Dans une étude mise à jour le 3 février 2026, Surfer rapporte lui aussi des écarts entre applications et API, notamment pour ChatGPT et Perplexity. L'éditeur vend un outil qui collecte les réponses des applications : il a un intérêt commercial direct dans cette comparaison.
La recherche SparkToro menée avec Gumshoe montre un autre problème : les listes de recommandations changent lorsque les questions sont répétées. Les auteurs estiment toutefois que la fréquence d'apparition peut rester informative sur plusieurs relevés. Gumshoe commercialise également un outil de visibilité IA.
J'en retiens deux contrôles complémentaires pour un reporting : préciser où les réponses ont été collectées et vérifier la stabilité des observations. Une capture d'interface isolée reste insuffisante pour représenter tous les acheteurs.
Une source citée signifie-t-elle que la marque est recommandée ?
Un relevé devient difficile à interpréter lorsqu'il additionne des événements différents sous le mot « visibilité ». Pour une équipe marketing, je propose cette grille de lecture :
| Observation | Question à laquelle elle répond |
|---|---|
| Marque nommée dans la réponse | L'entreprise figure-t-elle dans le texte ? |
| Marque recommandée pour le besoin | Est-elle proposée comme une option pertinente ? |
| Page du site citée | Un lien vers un contenu de l'entreprise est-il affiché ? |
| Source externe citée | Quel tiers accompagne la réponse sur ce sujet ? |
Exemple fictif : une entreprise publie un guide sur le choix d'un CRM. Son guide est cité, mais le texte recommande trois logiciels concurrents. Le relevé peut enregistrer une citation du site et aucune recommandation de son offre. Les deux observations sont cohérentes.
Quelles questions poser à un fournisseur de suivi de visibilité IA ?
La grille ci-dessous sert à obtenir des éléments vérifiables pendant une démonstration. Elle s'applique aussi à un dispositif interne ou à la restitution d'un prestataire.
| Point de contrôle | Élément à demander |
|---|---|
| Origine des données | D'où viennent les réponses : l'application, une API ou un autre service ? |
| Conditions | Quel pays, quelle langue et quel contexte représentent-elles ? |
| Recherche web | L'outil vérifie-t-il si une recherche sur le web a réellement eu lieu ? |
| Questions suivies | Correspondent-elles aux questions de nos acheteurs ? Peut-on les consulter ? |
| Répétitions | Combien de fois sont-elles posées, et à quelles dates ? |
| Signification du score | Compte-t-il les marques nommées, les recommandations ou les liens ? Sur combien de réponses ? |
| Vérification | Peut-on ouvrir les réponses qui justifient le score ? |
| Suivi dans le temps | Serons-nous prévenus si la méthode de mesure change ? |
Pour arbitrer un achat, je demanderais de parcourir un relevé complet : partir de l'indicateur affiché, ouvrir la question, lire la réponse, retrouver la marque et vérifier les sources. Si cette chaîne reste inaccessible, l'équipe dépend de la définition du fournisseur sans pouvoir examiner ses observations.
Comment vérifier son propre reporting sans refaire tout l'audit ?
Je propose de commencer par les questions qui déclenchent une décision coûteuse : refaire une page, financer un contenu ou changer de prestataire. Ce contrôle permet d'examiner le reporting ; il ne représente pas à lui seul l'ensemble du marché.
- Ouvrir les réponses derrière le score. Conserver les questions exactes, les dates et les conditions connues.
- Comparer avec l'application. Poser ces questions dans de nouvelles conversations, noter le contexte et conserver les réponses.
- Recommencer à plusieurs moments. Fixer les répétitions à l'avance et regarder si le désaccord revient. Une seule capture ne tranche pas.
- Vérifier ce qui est compté. Une marque nommée, un site cité et une recommandation restent trois observations distinctes. Une erreur de collecte reste une erreur, jamais une preuve d'absence.
- Choisir la suite. Un désaccord récurrent justifie une discussion sur la mesure. Une absence répétée des deux côtés invite à examiner l'offre, les contenus et les concurrents, sans préjuger de la cause.
Un pourcentage de réponses contenant la marque n'est pas un pourcentage d'acheteurs touchés. Le reporting doit préciser les questions testées et le nombre de réponses sur lequel il repose.
Le choix des questions et l'organisation du suivi sont détaillés dans mon article sur l'audit de visibilité IA.
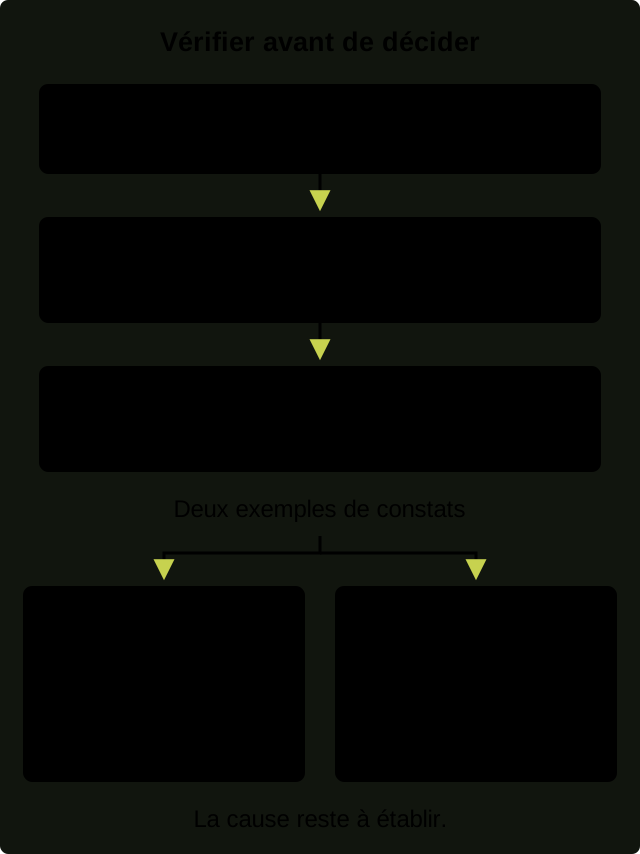
Deux exemples de constats à examiner. Ces pistes orientent l'analyse sans établir à elles seules la cause du problème.
Quelle décision une équipe marketing peut-elle en tirer ?
Pour un responsable acquisition, la première décision est de déterminer quel indicateur mérite d'entrer dans le reporting. Pour une agence, c'est de rendre explicite ce qu'elle observe et ce qu'elle extrapole. Pour un dirigeant, c'est de comprendre pourquoi une action sur le site passe avant une autre.
Ma recommandation : présenter séparément les résultats obtenus par API et ceux observés dans les applications. Et signaler tout changement de méthode : une hausse du score peut venir d'une nouvelle manière de compter.
Les visites, les demandes et les clients signés se suivent ensuite dans leur propre chaîne. Le rapprochement avec la visibilité peut éclairer une décision ; il ne suffit pas à démontrer une causalité. J'aborde cette continuité dans la mesure du coût par client signé.
Le résultat attendu d'un audit est une priorité de travail soutenue par des observations vérifiables. Pour examiner votre dispositif actuel, présentez-moi votre site, vos marchés et un exemple de reporting. Le périmètre utile se construit à partir de la décision que votre équipe doit prendre.
Questions fréquentes sur les outils de visibilité IA
Un outil qui utilise une API est-il inutile ?
Il peut servir à suivre des réponses dans des conditions connues et répétées. Pour interpréter ses résultats, la méthode de collecte doit être explicite. Je propose de compléter ce suivi par des observations dans l'application sur les questions qui comptent pour l'entreprise.
Une capture de ChatGPT suffit-elle à vérifier le score ?
Elle permet d'examiner une réponse, à un moment donné. Si elle contredit le tableau de bord, le point de départ est de comparer les conditions et de répéter les observations. Elle ne suffit pas à représenter ce que voient tous les clients.
Un score de 30 % signifie-t-il que 30 % des clients voient ma marque ?
Ce lien ne peut pas être déduit du score seul. Il faut connaître son calcul, les questions retenues et les réponses comptées. Un taux obtenu sur des questions choisies pour le suivi ne mesure pas automatiquement l'audience réelle.
Faut-il changer de prestataire si les résultats diffèrent ?
La première étape est de demander l'origine des réponses, les dates et le mode de calcul. Un écart expliqué peut être compatible avec un suivi utile. Une méthode inaccessible rend en revanche les décisions plus difficiles à justifier.
Comment relier ce suivi aux résultats commerciaux ?
En conservant séparément les observations de visibilité, les visites, les demandes et les clients signés. La source déclarée par le client peut compléter les données disponibles. Une hausse de visibilité doit ensuite être rapprochée des résultats, sans lui attribuer automatiquement chaque vente.
Analyse documentaire préparée le 22 septembre 2026. Les études, leurs périmètres et les documentations utilisées sont liés au fil de l'article. Les procédures proposées constituent une synthèse méthodologique à adapter au contexte de l'entreprise.
Pour votre entreprise
Savoir où votre entreprise apparaît dans les réponses des IA.
Je mesure votre visibilité sur Google et dans les réponses des IA, puis je vous aide à mettre les priorités en œuvre.